中文 OG 圖為什麼變豆腐:satori 同名字型與下載順序
10 月初,這個部落格的中文 OG 圖壞了兩次,中文全變豆腐,英文版正常。第一次我以為 build 時向 Google Fonts 抓字型失敗,加了重試,抓不到便讓 build 失敗,隔天卻又出事。查下去才發現每次下載都成功,前一天修錯了地方。
原因是 satori 會依卡片上缺字的語言片段各要一次字型,我卻把抓回來的 CJK 子集都登記成 Noto Serif TC。實測 satori 0.26.0 對名稱、字重和樣式相同的子集,只採用先完成的那份,這跟原始碼一致。我推測全形冒號的子集很小,常常先到,整張卡的中文就沒字型可用。最後改用本機字型切片,各自用不同名稱登記,build 時不再下載,缺字就讓 build 失敗。以下記下修正過程,以及可在本機執行的最小重現。
卡片原本怎麼做
本站是 Astro 靜態網站,用 Cloudflare Workers Builds 部署。OG 卡片是 1200x630 的 PNG,build 時由 satori 把節點樹轉成 SVG,再用 resvg 轉成 PNG,程式在 src/lib/og.ts,路由在 src/pages/og/[lang]/[slug].png.ts。卡片有 Great Vibes 寫的「Just a void」、副標「學海無涯」、標籤框、文章標題,以及年月日格式的日期。
拉丁字型直接用 @fontsource 的 woff 檔。整套 CJK 字型太大,舊版就在 build 時呼叫 Google Fonts 的 CSS2 API,帶上 text= 參數,拿到為這次請求最佳化的字型檔,官方文件說某些情況下最多可省下九成的檔案大小。當時用的 satori 不支援 woff2,為了讓 Google 回 woff,User-Agent 假裝成 Chrome 30。
satori 接受 TTF、OTF 和 WOFF 字型,以 { name, data, weight, style } 物件傳入。某段文字找不到字型時,會呼叫 loadAdditionalAsset(code, segment),code 是偵測到的語言代碼,emoji 是 'emoji',segment 是要畫的文字。舊版的 loadAdditionalAsset 把 segment 傳給 loadCJK(segment),回傳 [{ name: 'Noto Serif TC', data, ... }]。loadCJK 固定在要求的字後面加上 :,。、;!?「」『』()【】《》〈〉—…·,讓每份子集都帶著常用全形標點。
每次呼叫都回傳同一個 family name,README 沒有說明兩個同名字型怎麼處理。
10 月 2 日:第一次修,方向錯了
〈同一筆付款送了兩次:從 Santander 的聖誕節講冪等與重送〉發出後,中文 OG 卡全是豆腐,連副標「學海無涯」和日期裡的「年月日」都成了方框,英文卡正常。貼到 Threads 的預覽也顯示這張壞圖。
壞掉的 PNG 只有 33.5 KB,正常的約 52 KB。當時我以為 Cloudflare build 期間有一次 Google Fonts 請求失敗,loadCJK 吃掉錯誤、回傳 null,satori 找不到字型就畫豆腐,build 卻照樣成功。舊的專案說明甚至寫著「偶發、重 build 即可」。
當晚的 commit 040df5c 加了重試,字型抓取失敗時最多試三次,間隔 0.5 秒和 1 秒,並檢查 res.ok。正式 build 時抓不到就丟錯,讓部署失敗,commit message 裡寫的用意是讓前一版繼續上線;開發和測試環境維持豆腐 fallback,另外也補了測試。隔天才知道,那次下載沒有失敗。
10 月 3 日:下載全部成功,還是豆腐
隔天,44 張中文 OG 卡有 28 張是豆腐,正常的卡也有標題帶冒號的。每次字型下載都成功,前一天加的重試和丟錯都沒觸發。f412d80 的 commit message 記下當時的理解:satori 對每個語言片段各呼叫一次 loadAdditionalAsset,卡上的全形「:」或「,」自成一段,每份子集卻都登記成 Noto Serif TC,只含標點的子集便遮住了中文子集(shadowed)。訊息沒寫哪份先到,要到後面的重現才確認。satori 其實只對既有字型缺字的片段才呼叫這個函式,當時沒有預先登記 CJK 字型,所以每個 CJK 片段都缺字。
這一版改成整張卡只載一份涵蓋所有文字的子集,satori 問哪一段都回傳同一份。載入後用 @shuding/opentype.js 解析,任何 CJK 字沒有 glyph 就丟錯,所有環境都一樣,也不重試,satori 要求卡片文字以外的字時也丟錯。
之後我記下「這次的豆腐跟下載失敗無關,重 build 不一定會好」(重 build 可能改變下載完成的順序)。動到 OG 或字型,發文前就先看一張標題帶「:」的中文卡。
把舊 commit 重新 build 一次
為了寫這篇,我用 git archive 040df5c 取出舊版,npm ci 後跑 astro build,44 張中文卡都產生了,build 以 exit 0 結束,網路正常,每次字型請求都成功。我挑了三張來看:
- idempotency-and-retries:所有 CJK 字都是豆腐,全形冒號「:」正常,檔案是 33,536 bytes。
- jaeger-distributed-tracing-with-otel(標題「Jaeger 入門:用 OpenTelemetry 串起分散式追蹤」):同樣全部是豆腐,冒號正常。
- postgres-scheduled-sql-pitfalls(標題「PostgreSQL 排程 SQL 的三個坑」,沒有全形標點):正常。
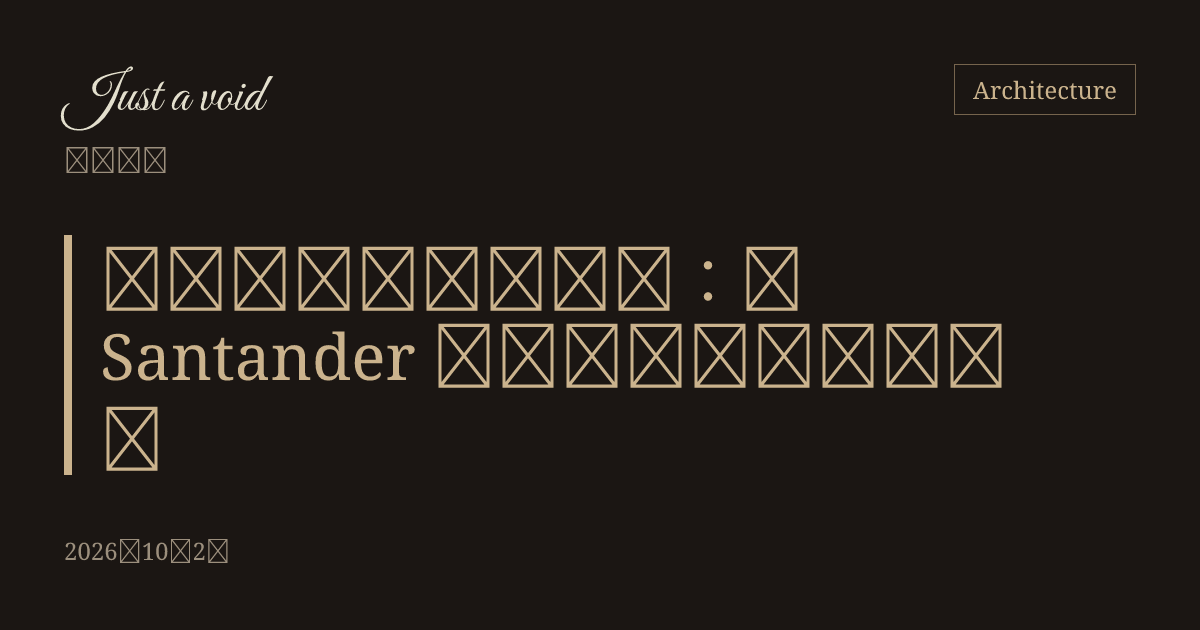
我在暫存副本裡加了 console.log,印出 satori 向 loadAdditionalAsset 要的片段:
OGSEG "同一筆付款送了兩次:從 " "學海無涯同一筆付款送了兩次從的聖誕節講冪等與重年月日"
OGSEG "同一筆付款送了兩次:從 " ":"
OGSEG "PostgreSQL 排" "學海無涯排程的三個坑年月日"
OGSEG "Jaeger 入門:用 " "學海無涯入門用串起分散式追蹤年月日"
OGSEG "Jaeger 入門:用 " ":"
第一組引號是卡片標題開頭,第二組是 satori 要的片段:副標、標題和日期的 CJK 文字合成一段,全形冒號另問一次。這次的記錄裡,標題沒有全形標點的卡只問了一次,跟上面三張的結果吻合。
最小重現:兩份字型的完成順序
只看片段數還解釋不通。我另寫一支重現程式,用 satori 節點重建卡片版面,省去把 HTML 轉成節點這一步,照樣向 Google Fonts 抓字型,idempotency 那張卻畫得出來。讓冒號那段不回傳任何內容,PNG 仍和前一張 byte 相同,多問一段不一定會出問題。
接著試下載完成的順序。race.mjs 把 @fontsource 的兩個切片都登記成 Noto Serif TC,切片 120 有「幾布落」,切片 123 有「:」。兩次執行只差在第二次的 CJK loadAdditionalAsset 多等 50 毫秒,用來模擬大子集下載較慢。
// Two segments, two subsets, one family name. The only difference between runs is
// which loadAdditionalAsset promise settles first.
import { readFileSync, writeFileSync } from 'node:fs';
import satori from 'satori';
import { Resvg } from '@resvg/resvg-js';

const slice = (n) => readFileSync(`node_modules/@fontsource/noto-serif-tc/files/noto-serif-tc-${n}-400-normal.woff`);
const latin = readFileSync('node_modules/@fontsource/noto-serif/files/noto-serif-latin-400-normal.woff');
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));
const text = '幾布落:';            // 幾布落 live in slice 120, the full-width colon in slice 123

for (const slowFirst of [false, true]) {
  const order = [];
  const svg = await satori(
    { type: 'div', props: { style: { display: 'flex', fontSize: 64, background: '#fff', padding: 40 }, children: text } },
    {
      width: 600,
      height: 160,
      fonts: [{ name: 'Noto Serif', data: latin, weight: 400, style: 'normal' }],
      loadAdditionalAsset: async (code, segment) => {
        const isColon = segment === ':';
        if (slowFirst && !isColon) await sleep(50);   // the big subset takes longer to download
        order.push(segment);
        return [{ name: 'Noto Serif TC', data: slice(isColon ? 123 : 120), weight: 400, style: 'normal' }];
      },
    },
  );
  const file = `race-${slowFirst ? 'colon-first' : 'han-first'}.png`;
  writeFileSync(file, new Resvg(svg, { font: { loadSystemFonts: false } }).render().asPng());
  console.log(`${file}: settled in order ${order.map((s) => JSON.stringify(s)).join(' then ')}`);
}
用 npm i satori@0.26.0 @resvg/resvg-js@2.6.2 @fontsource/noto-serif-tc@5.3.0 @fontsource/noto-serif@5.3.0 安裝套件,在 Mac 的 Node 26.13.0 和 Linux 容器的 Node 22.23.4 執行,輸出一致,兩邊產出的 PNG 也跟下圖 byte 相同:
race-han-first.png: settled in order "幾布落" then ":"
race-colon-first.png: settled in order ":" then "幾布落"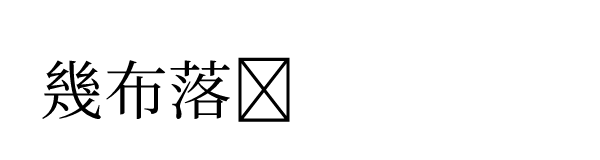
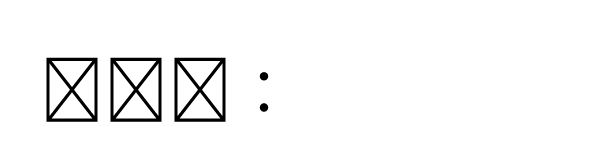
CJK 子集先回來時,「幾布落」正常,冒號是豆腐;冒號子集先回來,「幾布落」就成了三個方框,冒號正常。兩份子集的字重、樣式相同,也都沒指定語言,satori 在同一個 family name 下選中先 settle 的那份;後到的也存進去了,卻不會用來補缺字。README 沒有寫,原始碼則能解釋:0.26.0 的 src/satori.ts 把每個 loadAdditionalAsset 的結果依 promise 完成順序放進同一個陣列,全部完成後才交給 addFonts;src/font.ts 從同名的第一份開始挑,只有字重或樣式更接近要求時才換下一份,兩份都是 400 normal,就一直選先到的那份。原始碼沒有註解說明這是刻意設計還是副作用。f412d80 的 commit message 只寫標點子集遮住了中文子集,實測和原始碼才確認,被選中的是先到的那份。
對照舊版 build,我推測冒號子集只含固定那串標點,檔案很小,通常先回來,帶全形標點的卡便常常壞掉,下載順序偶爾反過來才正常。這個推測能解釋 44 張裡只有 28 張壞掉,也能解釋為什麼有些帶冒號的卡是正常的。但我無法重放 10 月 3 日那次 build 的時序,這部分仍是推測。
現在的做法
f412d80 仍在 build 時抓字型,同晚的 1b7f522 才移除這一步,現在的 og.ts 沿用這個做法。
Noto Serif TC 改用 @fontsource/noto-serif-tc 的 woff 檔,依 unicode-range 分成一百多個切片,由 package-lock 鎖定版本。每個切片各用不同名稱登記,從 Noto Serif TC 0、Noto Serif TC 1 排下去,satori 缺字時沿這串名稱往後 fallback。AGENTS.md 把同字重、同樣式的限制簡寫成:「satori 每個 family name 只保留一個字型,其他名稱都當 fallback,所以每個切片要用不同名稱」。Great Vibes 最後登記,讓拉丁和 CJK 字型優先補位。
loadAdditionalAsset 現在對 emoji 回傳空字串,其餘情況丟出 OG card text has no glyph in the bundled fonts,讓 build 失敗,不產出豆腐。兩條測試分別要求韓文標題「한국어 제목」丟錯,中文卡在 fetch 被 stub 成 reject 時仍正常產出,且未呼叫 fetch。og.ts 的註解寫著:「The build never fetches a font, so the same commit always renders the same cards and a network blip cannot produce tofu.」
同一天也關掉 resvg 的系統字型掃描。satori 已把字轉成路徑,resvg 不必再找字型,每張卡省約 0.4 秒,整個 build 從 63 秒降到 28 到 34 秒(commit f777174)。
專案裡留下的檢查
這些檢查後來寫進 repo 規則,用 satori 產 CJK 卡片時也可參考。除了看帶冒號的卡,還要看 PNG 大小與 bytes:這次的豆腐卡壓縮後小很多,33 KB 對 52 KB,可當線索;fetch 成功仍可能拿到缺字的子集,要確認 satori 拿到的 bytes 有所需 glyph。修好卡片後,也要檢查 Threads、Facebook 等平台的預覽是否仍是舊圖。Facebook 可用 Meta Sharing Debugger 要求重抓,其他平台依各自支援的方式處理。
補充筆記
- 舊版在 build 時向 Google Fonts 抓 CJK 子集,全登記成
Noto Serif TC。 - 在這次字型配置下,satori 對缺字的語言片段各呼叫一次
loadAdditionalAsset,全形冒號自成一段,帶「:」的卡便抓兩份子集。 - 子集同名且字重、樣式相同,實測 satori 0.26.0 採用先 settle 的那份,後到的無法補位;我推測冒號子集小,通常先到,中文就沒字型可用。
- 10 月 2 日加的重試與丟錯沒觸發,因為每次下載都成功,隔天 44 張卡仍壞了 28 張。
- 現在 build 不抓字型,@fontsource 每個切片各用不同名稱,缺 glyph 就讓 build 失敗。
- 動過字型後先看帶「:」的中文卡與 PNG 大小,修好後再查社群預覽是否需要重新抓取。
延伸閱讀
- Vercel〈satori README〉:列出支援的字型格式、
fonts物件與loadAdditionalAsset介面。連結指向現行版,格式支援與本文採用的舊版不同;兩版都未說明同名、同字重與同樣式的字型怎麼取捨。 - Vercel〈satori 0.26.0 src/font.ts〉:同名字型存成陣列,
get從第一份挑,字重與樣式相同時不換;搭配同版本的 src/satori.ts 看loadAdditionalAsset的結果如何依完成順序加入。 - Google Fonts〈Google Fonts CSS2 API〉:舊版用來拿子集的
text=參數。 - Wikipedia〈Noto fonts〉:「豆腐」的說法與 Noto 名字的來源 no tofu。
- 維基百科〈競爭危害〉:結果取決於無法控制的事件順序或時機,本文的字型下載便是一例。
- ogp.me〈The Open Graph protocol〉:
og:image是四個必要屬性之一,用來指定代表頁面的圖片。
想法與技術判斷出自 Sheng,和 Claude 一起起草 · 起草 Claude Opus,統籌 Claude Fable,Grok(grok-4.7)查資料與調語氣,Codex(gpt-6-astra)審稿與精簡,Claude Opus 5.5 二審;範例在 satori 0.26.0、@resvg/resvg-js 2.6.2、@fontsource/noto-serif-tc 5.3.0、Node 26.13.0 與 Node 22.23.4 實測。